Redis-Best-Practice
前言
这篇文章我想和你聊一聊 Redis 的最佳实践。
你的项目或许已经使用 Redis 很长时间了,但在使用过程中,你可能还会或多或少地遇到以下问题:
- 我的 Redis 内存为什么增长这么快?
- 为什么我的 Redis 操作延迟变大了?
- 如何降低 Redis 故障发生的频率?
- 日常运维 Redis 需要注意什么?
- 部署 Redis 时,如何做好资源规划?
- Redis 监控重点要关注哪些指标?
尤其是当你的项目越来越依赖 Redis 时,这些问题就变得尤为重要。
此时,你迫切需要一份「最佳实践指南」 。
这篇文章,我将从以下七个维度,带你「全面」分析 Redis 的最佳实践优化:
- 内存
- 性能
- 高可靠
- 日常运维
- 资源规划
- 监控
- 安全
如何使用 Redis 更节省内存?
首先,我们来看一下 Redis 内存方面的优化。
众所周知,Redis 的性能之所以如此之高,原因就在于它的数据都存储在「内存」中,所以访问 Redis 中的数据速度极快。
但从资源利用率层面来说,机器的内存资源相比于磁盘,还是比较昂贵的。
当你的业务应用在 Redis 中存储数据很少时,你可能并不太关心内存资源的使用情况。但随着业务的发展,你的业务存储在 Redis 中的数据就会越来越多。
如果没有提前制定好内存优化策略,那么等业务开始增长时,Redis 占用的内存也会开始膨胀。
所以,提前制定合理的内存优化策略,对于资源利用率的提升是很有必要的。
那在使用 Redis 时,怎样做才能更节省内存呢?这里我给你总结了 6 点建议,我们依次来看:
1) 控制 key 的长度
最简单直接的内存优化,就是控制 key 的长度。
在开发业务时,你需要提前预估整个 Redis 中写入 key 的数量,如果 key 数量达到了百万级别,那么,过长的 key 名也会占用过多的内存空间。
所以,你需要保证 key 在简单、清晰的前提下,尽可能把 key 定义得短一些。
例如,原有的 key 为 user:book:123,则可以优化为 u:bk:123。
这样一来,你的 Redis 就可以节省大量的内存,这个方案对内存的优化非常直接和高效。
2) 避免存储 bigkey
除了控制 key 的长度之外,你同样需要关注 value 的大小,如果大量存储 bigkey,也会导致 Redis 内存增长过快。
除此之外,客户端在读写 bigkey 时,还有产生性能问题(下文会具体详述)。
所以,你要避免在 Redis 中存储 bigkey,我给你的建议是:
String:大小控制在 10KB 以下List/Hash/Set/ZSet:元素数量控制在 1 万以下
3) 选择合适的数据类型
Redis 提供了丰富的数据类型,这些数据类型在实现上,也对内存使用做了优化。具体来说就是,一种数据类型对应多种数据结构来实现:
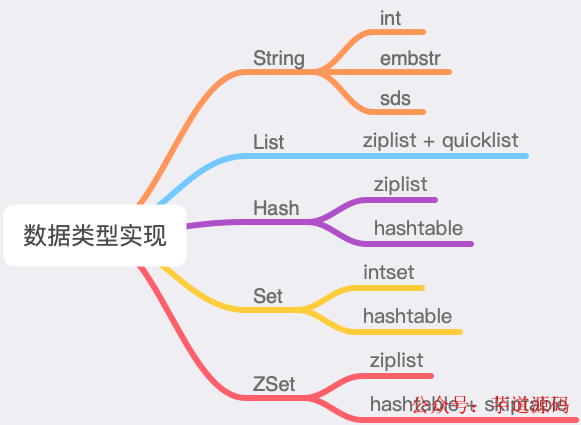
例如,String、Set 在存储 int 数据时,会采用整数编码存储。Hash、ZSet 在元素数量比较少时(可配置),会采用压缩列表(ziplist)存储,在存储比较多的数据时,才会转换为哈希表和跳表。
作者这么设计的原因,就是为了进一步节约内存资源。
那么你在存储数据时,就可以利用这些特性来优化 Redis 的内存。这里我给你的建议如下:
String、Set:尽可能存储 int 类型数据Hash、ZSet:存储的元素数量控制在转换阈值之下,以压缩列表存储,节约内存
4) 把 Redis 当作缓存使用
Redis 数据存储在内存中,这也意味着其资源是有限的。你在使用 Redis 时,要把它当做缓存来使用,而不是数据库。
所以,你的应用写入到 Redis 中的数据,尽可能地都设置「过期时间」。
业务应用在 Redis 中查不到数据时,再从后端数据库中加载到 Redis 中。

采用这种方案,可以让 Redis 中只保留经常访问的「热数据」,内存利用率也会比较高。
5) 实例设置 maxmemory + 淘汰策略
虽然你的 Redis key 都设置了过期时间,但如果你的业务应用写入量很大,并且过期时间设置得比较久,那么短期间内 Redis 的内存依旧会快速增长。
如果不控制 Redis 的内存上限,也会导致使用过多的内存资源。
对于这种场景,你需要提前预估业务数据量,然后给这个实例设置 maxmemory 控制实例的内存上限,这样可以避免 Redis 的内存持续膨胀。
配置了 maxmemory,此时你还要设置数据淘汰策略,而淘汰策略如何选择,你需要结合你的业务特点来决定:
volatile-lru / allkeys-lru:优先保留最近访问过的数据volatile-lfu / allkeys-lfu:优先保留访问次数最频繁的数据(4.0+版本支持)volatile-ttl:优先淘汰即将过期的数据volatile-random / allkeys-random:随机淘汰数据
6) 数据压缩后写入 Redis
以上方案基本涵盖了 Redis 内存优化的各个方面。
如果你还想进一步优化 Redis 内存,你还可以在业务应用中先将数据压缩,再写入到 Redis 中(例如采用 snappy、gzip 等压缩算法)。
当然,压缩存储的数据,客户端在读取时还需要解压缩,在这期间会消耗更多 CPU 资源,你需要根据实际情况进行权衡。
以上就是「节省内存资源」方面的实践优化,是不是都比较简单?
下面我们来看「性能」方面的优化。
如何持续发挥 Redis 的高性能?
当你的系统决定引入 Redis 时,想必看中它最关键的一点就是:性能 。
我们知道,一个单机版 Redis 就可以达到 10W QPS,这么高的性能,也意味着如果在使用过程中发生延迟情况,就会与我们的预期不符。
所以,在使用 Redis 时,如何持续发挥它的高性能,避免操作延迟的情况发生,也是我们的关注焦点。
在这方面,我给你总结了 13 条建议:
1) 避免存储 bigkey
存储 bigkey 除了前面讲到的使用过多内存之外,对 Redis 性能也会有很大影响。
由于 Redis 处理请求是单线程的,当你的应用在写入一个 bigkey 时,更多时间将消耗在「内存分配」上,这时操作延迟就会增加。同样地,删除一个 bigkey 在「释放内存」时,也会发生耗时。
而且,当你在读取这个 bigkey 时,也会在「网络数据传输」上花费更多时间,此时后面待执行的请求就会发生排队,Redis 性能下降。
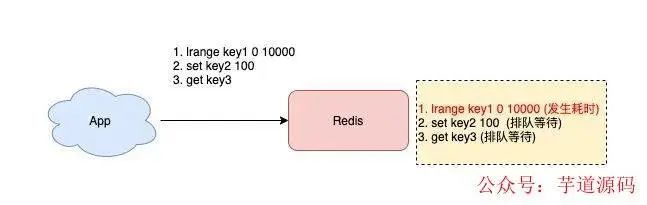
所以,你的业务应用尽量不要存储 bigkey,避免操作延迟发生。
如果你确实有存储 bigkey 的需求,你可以把 bigkey 拆分为多个小 key 存储。
2) 开启 lazy-free 机制
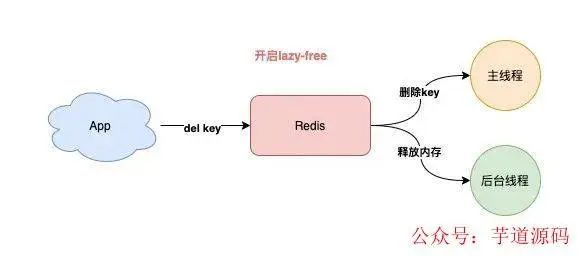
如果你无法避免存储 bigkey,那么我建议你开启 Redis 的 lazy-free 机制。(4.0+版本支持)
当开启这个机制后,Redis 在删除一个 bigkey 时,释放内存的耗时操作,将会放到后台线程中去执行,这样可以在最大程度上,避免对主线程的影响。
3) 不使用复杂度过高的命令
Redis 是单线程模型处理请求,除了操作 bigkey 会导致后面请求发生排队之外,在执行复杂度过高的命令时,也会发生这种情况。
因为执行复杂度过高的命令,会消耗更多的 CPU 资源,主线程中的其它请求只能等待,这时也会发生排队延迟。
所以,你需要避免执行例如 SORT、SINTER、SINTERSTORE、ZUNIONSTORE、ZINTERSTORE 等聚合类命令。
对于这种聚合类操作,我建议你把它放到客户端来执行,不要让 Redis 承担太多的计算工作。
4) 执行 O(N) 命令时,关注 N 的大小
规避使用复杂度过高的命令,就可以高枕无忧了么?
答案是否定的。
当你在执行 O(N) 命令时,同样需要注意 N 的大小。
如果一次性查询过多的数据,也会在网络传输过程中耗时过长,操作延迟变大。
所以,对于容器类型(List/Hash/Set/ZSet),在元素数量未知的情况下,一定不要无脑执行 LRANGE key 0 -1 / HGETALL / SMEMBERS / ZRANGE key 0 -1。
在查询数据时,你要遵循以下原则:
- 先查询数据元素的数量(
LLEN/HLEN/SCARD/ZCARD) - 元素数量较少,可一次性查询全量数据
- 元素数量非常多,分批查询数据(
LRANGE/HASCAN/SSCAN/ZSCAN)
5) 关注 DEL 时间复杂度
你没看错,在删除一个 key 时,如果姿势不对,也有可能影响到 Redis 性能。
删除一个 key,我们通常使用的是 DEL 命令,回想一下,你觉得 DEL 的时间复杂度是多少?
O(1) ?其实不一定。
当你删除的是一个 String 类型 key 时,时间复杂度确实是 O(1)。
但当你要删除的 key 是 List/Hash/Set/ZSet 类型,它的复杂度其实为 O(N),N 代表元素个数。
也就是说,删除一个 key,其元素数量越多,执行 DEL 也就越慢!
原因在于,删除大量元素时,需要依次回收每个元素的内存,元素越多,花费的时间也就越久!
而且,这个过程默认是在主线程中执行的,这势必会阻塞主线程,产生性能问题。
那删除这种元素比较多的 key,如何处理呢?
我给你的建议是,分批删除:
List类型:执行多次LPOP/RPOP,直到所有元素都删除完成Hash/Set/ZSet类型:先执行HSCAN/SSCAN/SCAN查询元素,再执行HDEL/SREM/ZREM依次删除每个元素
没想到吧?一个小小的删除操作,稍微不小心,也有可能引发性能问题,你在操作时需要格外注意。
6) 批量命令代替单个命令
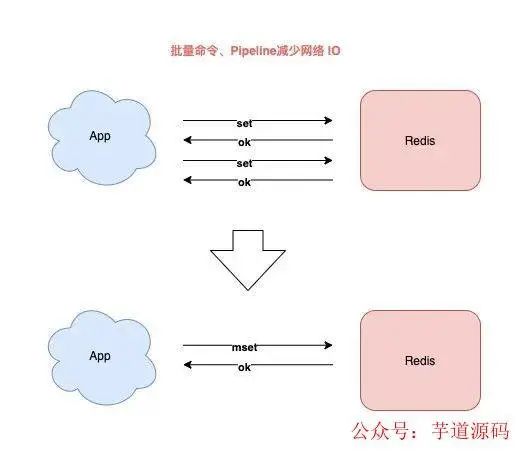
当你需要一次性操作多个 key 时,你应该使用批量命令来处理。
批量操作相比于多次单个操作的优势在于,可以显著减少客户端、服务端的来回网络 IO 次数。
所以我给你的建议是:
- String / Hash 使用 MGET/MSET 替代 GET/SET,HMGET/HMSET 替代 HGET/HSET
- 其它数据类型使用 Pipeline,打包一次性发送多个命令到服务端执行
7) 避免集中过期 key
Redis 清理过期 key 是采用定时 + 懒惰的方式来做的,而且这个过程都是在主线程中执行。
如果你的业务存在大量 key 集中过期的情况,那么 Redis 在清理过期 key 时,也会有阻塞主线程的风险。

想要避免这种情况发生,你可以在设置过期时间时,增加一个随机时间,把这些 key 的过期时间打散,从而降低集中过期对主线程的影响。
8) 使用长连接操作 Redis,合理配置连接池
你的业务应该使用长连接操作 Redis,避免短连接。
当使用短连接操作 Redis 时,每次都需要经过 TCP 三次握手、四次挥手,这个过程也会增加操作耗时。
同时,你的客户端应该使用连接池的方式访问 Redis,并设置合理的参数,长时间不操作 Redis 时,需及时释放连接资源。
9) 只使用 db0
尽管 Redis 提供了 16 个 db,但我只建议你使用 db0。
为什么呢?我总结了以下 3 点原因:
- 在一个连接上操作多个 db 数据时,每次都需要先执行 SELECT,这会给 Redis 带来额外的压力
- 使用多个 db 的目的是,按不同业务线存储数据,那为何不拆分多个实例存储呢?拆分多个实例部署,多个业务线不会互相影响,还能提高 Redis 的访问性能
- Redis Cluster 只支持 db0,如果后期你想要迁移到 Redis Cluster,迁移成本高
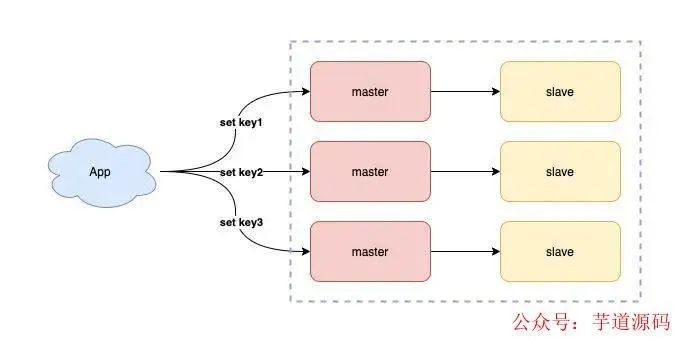
10) 使用读写分离 + 分片集群
如果你的业务读请求量很大,那么可以采用部署多个从库的方式,实现读写分离,让 Redis 的从库分担读压力,进而提升性能。
 如果你的业务写请求量很大,单个 Redis 实例已无法支撑这么大的写流量,那么此时你需要使用分片集群,分担写压力。
11) 不开启 AOF 或 AOF 配置为每秒刷盘
如果对于丢失数据不敏感的业务,我建议你不开启 AOF,避免 AOF 写磁盘拖慢 Redis 的性能。
如果确实需要开启 AOF,那么我建议你配置为 appendfsync everysec,把数据持久化的刷盘操作,放到后台线程中去执行,尽量降低 Redis 写磁盘对性能的影响。
12) 使用物理机部署 Redis
Redis 在做数据持久化时,采用创建子进程的方式进行。
而创建子进程会调用操作系统的 fork 系统调用,这个系统调用的执行耗时,与系统环境有关。
虚拟机环境执行 fork 的耗时,要比物理机慢得多,所以你的 Redis 应该尽可能部署在物理机上。
13) 关闭操作系统内存大页机制
Linux 操作系统提供了内存大页机制,其特点在于,每次应用程序向操作系统申请内存时,申请单位由之前的 4KB 变为了 2MB。
这会导致什么问题呢?
当 Redis 在做数据持久化时,会先 fork 一个子进程,此时主进程和子进程共享相同的内存地址空间。
当主进程需要修改现有数据时,会采用写时复制(Copy On Write)的方式进行操作,在这个过程中,需要重新申请内存。
如果申请内存单位变为了 2MB,那么势必会增加内存申请的耗时,如果此时主进程有大量写操作,需要修改原有的数据,那么在此期间,操作延迟就会变大。
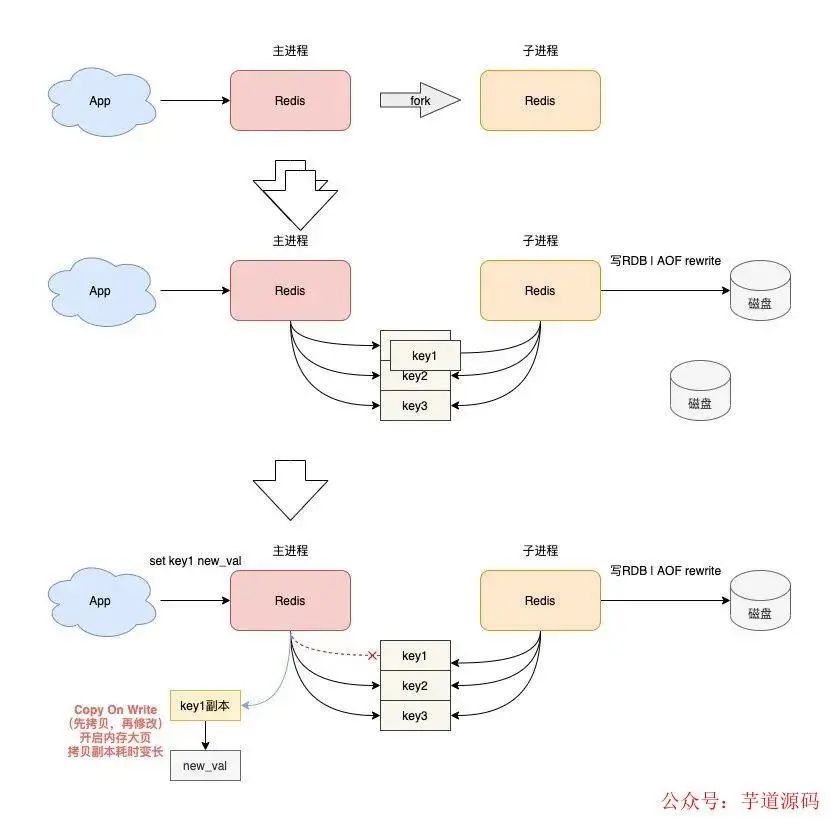
所以,为了避免出现这种问题,你需要在操作系统上关闭内存大页机制。
好了,以上这些就是 Redis 「高性能」方面的实践优化。如果你非常关心 Redis 的性能问题,可以结合这些方面针对性优化。
我们再来看 Redis 「可靠性」如何保证。
如何保证 Redis 的可靠性?
这里我想提醒你的是,保证 Redis 可靠性其实并不难,但难的是如何做到「持续稳定」。
下面我会从「资源隔离」、「多副本」、「故障恢复」这三大维度,带你分析保障 Redis 可靠性的最佳实践。
1) 按业务线部署实例
提升可靠性的第一步,就是「资源隔离」。
你最好按不同的业务线来部署 Redis 实例,这样当其中一个实例发生故障时,不会影响到其它业务。
这种资源隔离的方案,实施成本是最低的,但成效却是非常大的。
2) 部署主从集群
如果你只使用单机版 Redis,那么就会存在机器宕机服务不可用的风险。
所以,你需要部署「多副本」实例,即主从集群,这样当主库宕机后,依旧有从库可以使用,避免了数据丢失的风险,也降低了服务不可用的时间。
在部署主从集群时,你还需要注意,主从库需要分布在不同机器上,避免交叉部署。
这么做的原因在于,通常情况下,Redis 的主库会承担所有的读写流量,所以我们一定要优先保证主库的稳定性,即使从库机器异常,也不要对主库造成影响。
而且,有时我们需要对 Redis 做日常维护,例如数据定时备份等操作,这时你就可以只在从库上进行,这只会消耗从库机器的资源,也避免了对主库的影响。
3) 合理配置主从复制参数
在部署主从集群时,如果参数配置不合理,也有可能导致主从复制发生问题:
- 主从复制中断
- 从库发起全量复制,主库性能受到影响
在这方面我给你的建议有以下 2 点:
- 设置合理的
repl-backlog参数:过小的repl-backlog在写流量比较大的场景下,主从复制中断会引发全量复制数据的风险 -设置合理的slave client-output-buffer-limit:当从库复制发生问题时,过小的 buffer 会导致从库缓冲区溢出,从而导致复制中断
4) 部署哨兵集群,实现故障自动切换
只部署了主从节点,但故障发生时是无法自动切换的,所以,你还需要部署哨兵集群,实现故障的「自动切换」。
而且,多个哨兵节点需要分布在不同机器上,实例为奇数个,防止哨兵选举失败,影响切换时间。
以上这些就是保障 Redis「高可靠」实践优化,你应该也发现了,这些都是部署和运维层的优化。
除此之外,你可能还会对 Redis 做一些「日常运维」工作,这时你要注意哪些问题呢?
日常运维 Redis 需要注意什么?
如果你是 DBA 运维人员,在平时运维 Redis 时,也需要注意以下 6 个方面。** **
1) 禁止使用 KEYS/FLUSHALL/FLUSHDB 命令
执行这些命令,会长时间阻塞 Redis 主线程,危害极大,所以你必须禁止使用它。
如果确实想使用这些命令,我给你的建议是:
- SCAN 替换 KEYS
- 4.0+版本可使用 FLUSHALL/FLUSHDB ASYNC,清空数据的操作放在后台线程执行
2) 扫描线上实例时,设置休眠时间
不管你是使用 SCAN 扫描线上实例,还是对实例做 bigkey 统计分析,我建议你在扫描时一定记得设置休眠时间。
防止在扫描过程中,实例 OPS 过高对 Redis 产生性能抖动。
3) 慎用 MONITOR 命令
有时在排查 Redis 问题时,你会使用 MONITOR 查看 Redis 正在执行的命令。
但如果你的 Redis OPS 比较高,那么在执行 MONITOR 会导致 Redis 输出缓冲区的内存持续增长,这会严重消耗 Redis 的内存资源,甚至会导致实例内存超过 maxmemory,引发数据淘汰,这种情况你需要格外注意。

所以你在执行 MONITOR 命令时,一定要谨慎,尽量少用。
4) 从库必须设置为 slave-read-only
你的从库必须设置为 slave-read-only 状态,避免从库写入数据,导致主从数据不一致。
除此之外,从库如果是非 read-only 状态,如果你使用的是 4.0 以下的 Redis,它存在这样的 Bug:
从库写入了有过期时间的数据,不会做定时清理和释放内存。
这会造成从库的内存泄露!这个问题直到 4.0 版本才修复,你在配置从库时需要格外注意。
5) 合理配置 timeout 和 tcp-keepalive 参数
如果因为网络原因,导致你的大量客户端连接与 Redis 意外中断,恰好你的 Redis 配置的 maxclients 参数比较小,此时有可能导致客户端无法与服务端建立新的连接(服务端认为超过了 maxclients)。
造成这个问题原因在于,客户端与服务端每建立一个连接,Redis 都会给这个客户端分配了一个 client fd。
当客户端与服务端网络发生问题时,服务端并不会立即释放这个 client fd。
什么时候释放呢?
Redis 内部有一个定时任务,会定时检测所有 client 的空闲时间是否超过配置的 timeout 值。
如果 Redis 没有开启 tcp-keepalive 的话,服务端直到配置的 timeout 时间后,才会清理释放这个 client fd。
在没有清理之前,如果还有大量新连接进来,就有可能导致 Redis 服务端内部持有的 client fd 超过了 maxclients,这时新连接就会被拒绝。
针对这种情况,我给你的优化建议是:
- 不要配置过高的 timeout:让服务端尽快把无效的 client fd 清理掉
- Redis 开启 tcp-keepalive:这样服务端会定时给客户端发送 TCP 心跳包,检测连接连通性,当网络异常时,可以尽快清理僵尸 client fd
6) 调整 maxmemory 时,注意主从库的调整顺序
Redis 5.0 以下版本存在这样一个问题:从库内存如果超过了 maxmemory,也会触发数据淘汰。
在某些场景下,从库是可能优先主库达到 maxmemory 的(例如在从库执行 MONITOR 命令,输出缓冲区占用大量内存),那么此时从库开始淘汰数据,主从库就会产生不一致。
要想避免此问题,在调整 maxmemory 时,一定要注意主从库的修改顺序:
- 调大
maxmemory:先修改从库,再修改主库 - 调小
maxmemory:先修改主库,再修改从库
直到 Redis 5.0,Redis 才增加了一个配置 replica-ignore-maxmemory,默认从库超过 maxmemory 不会淘汰数据,才解决了此问题。
好了,以上这些就是「日常运维」Redis 需要注意的,你可以对各个配置项查漏补缺,看有哪些是需要优化的。
接下来,我们来看一下,保障 Redis「安全」都需要注意哪些问题。
Redis 安全如何保证?
无论如何,在互联网时代,安全问题一定是我们需要随时警戒的。
你可能听说过 Redis 被注入可执行脚本,然后拿到机器 root 权限的安全问题,都是因为在部署 Redis 时,没有把安全风险注意起来。
针对这方面,我给你的建议是:
- 不要把 Redis 部署在公网可访问的服务器上
- 部署时不使用默认端口 6379
- 以普通用户启动 Redis 进程,禁止 root 用户启动
- 限制 Redis 配置文件的目录访问权限
- 推荐开启密码认证
- 禁用/重命名危险命令(
KEYS/FLUSHALL/FLUSHDB/CONFIG/EVAL)
只要你把这些做到位,基本上就可以保证 Redis 的安全风险在可控范围内。
至此,我们分析了 Redis 在内存、性能、可靠性、日常运维方面的最佳实践优化。
除了以上这些,你还需要做到提前「预防」。
如何预防 Redis 问题?
要想提前预防 Redis 问题,你需要做好以下两个方面:
- 合理的资源规划
- 完善的监控预警
- 先来说资源规划。
在部署 Redis 时,如果你可以提前做好资源规划,可以避免很多因为资源不足产生的问题。这方面我给你的建议有以下 3 点:
- 保证机器有足够的 CPU、内存、带宽、磁盘资源
- 提前做好容量规划,主库机器预留一半内存资源,防止主从机器网络故障,引发大面积全量同步,导致主库机器内存不足的问题
- 单个实例内存建议控制在 10G 以下,大实例在主从全量同步、RDB 备份时有阻塞风险
再来看监控如何做。
监控预警是提高稳定性的重要环节,完善的监控预警,可以把问题提前暴露出来,这样我们才可以快速反应,把问题最小化。
这方面我给你的建议是:
- 做好机器 CPU、内存、带宽、磁盘监控,资源不足时及时报警,任意资源不足都会影响 Redis 性能
- 设置合理的
slowlog阈值,并对其进行监控,slowlog过多及时报警 - 监控组件采集 Redis INFO 信息时,采用长连接,避免频繁的短连接
- 做好实例运行时监控,重点关注
expired_keys、evicted_keys、latest_fork_usec指标,这些指标短时突增可能会有阻塞风险
总结
好了,总结一下,这篇文章我带你全面分析了 Redis 最佳实践的优化路径,其中包括内存资源、高性能、高可靠、日常运维、资源规划、监控、安全 7 个维度。
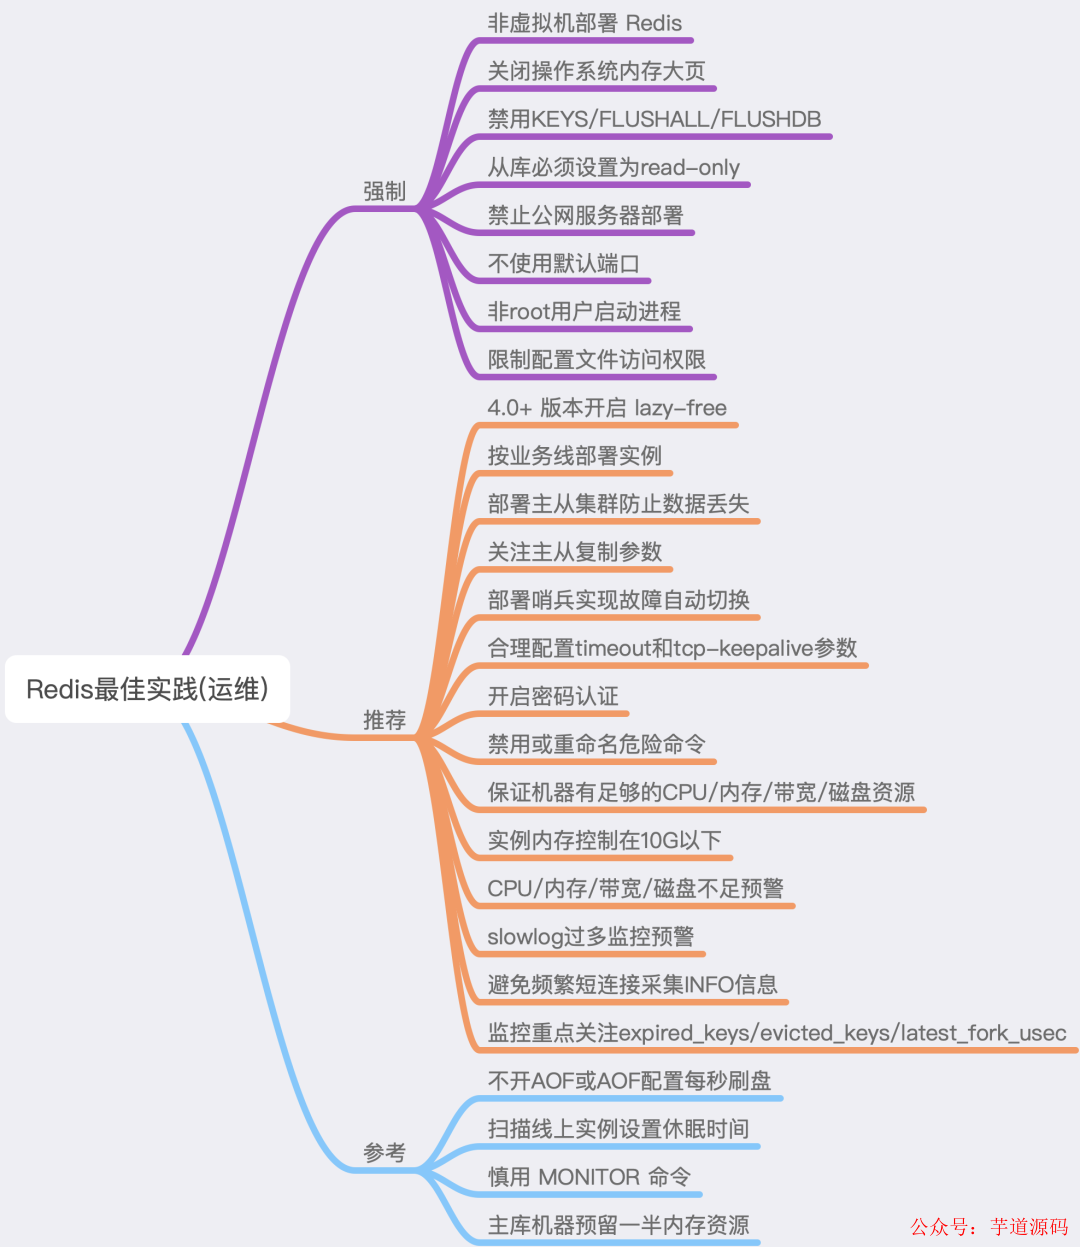
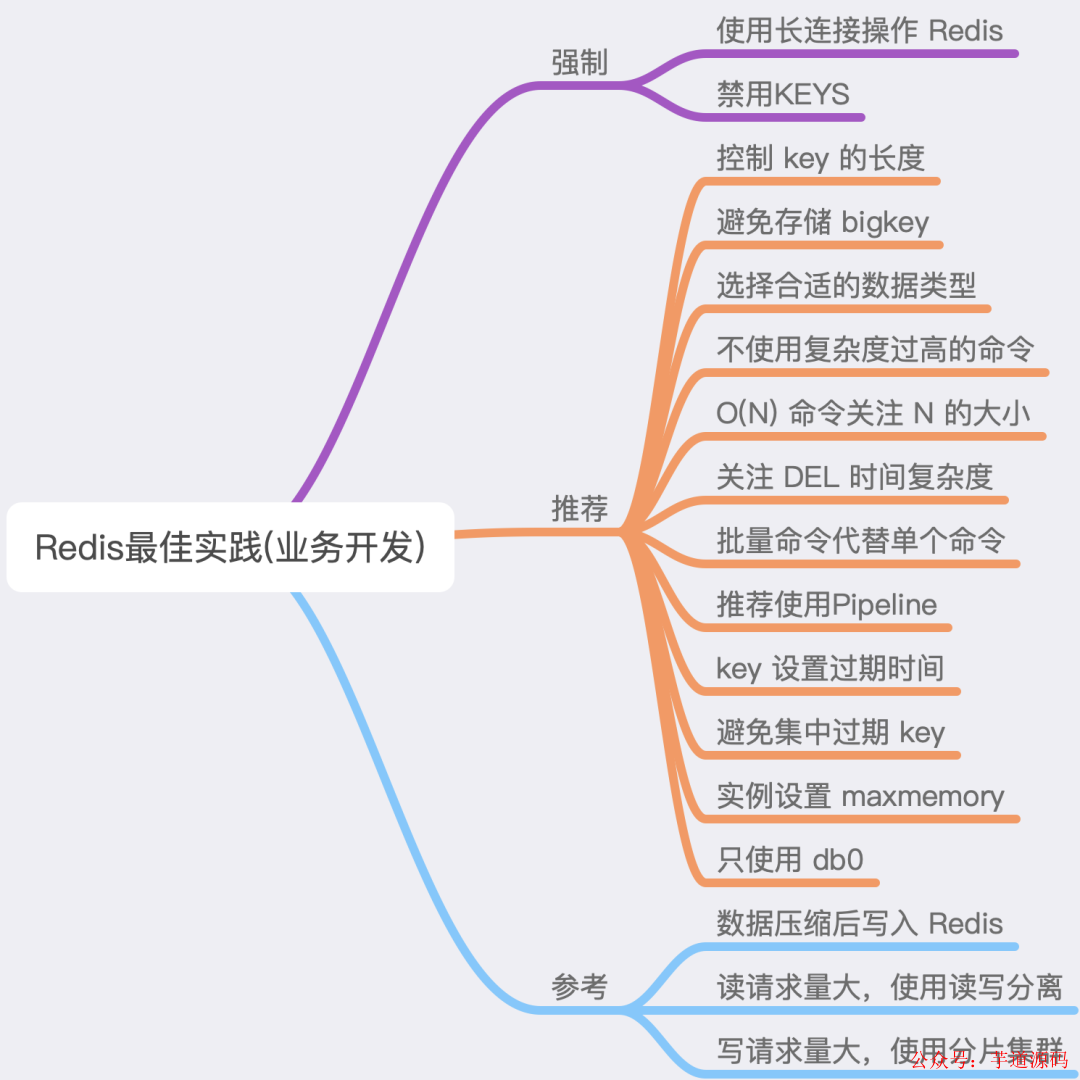
这里我画成了思维导图,方便你在实践时做参考。
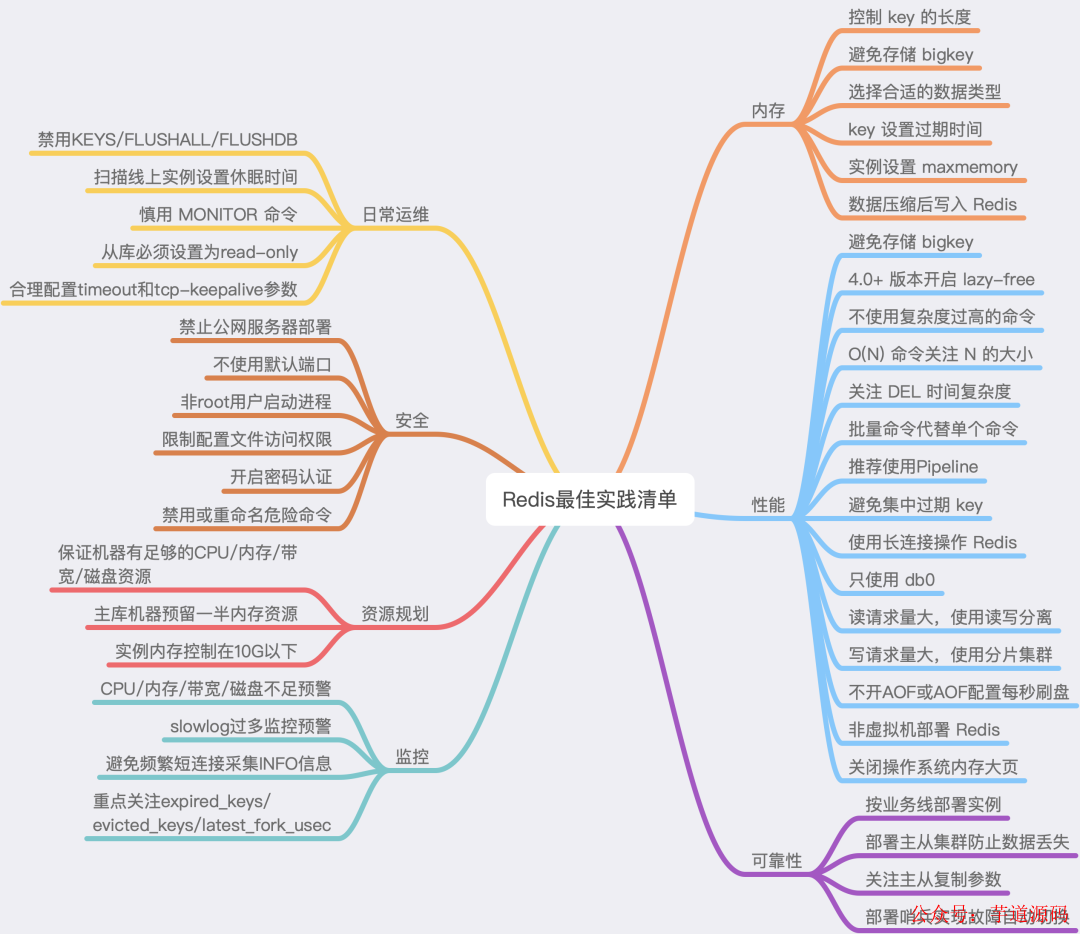
我还把这些实践优化,按照「业务开发」和「运维」两个维度,进一步做了划分。
并且以「强制」、「推荐」、「参考」3 个级别做了标注,这样你在实践优化时,就会更明确哪些该做,哪些需要结合实际的业务场景进一步分析。
这些级别的实施规则如下:
- 强制:需严格遵守,否则危害极大
- 推荐:推荐遵守,可提升性能、降低内存、便于运维
- 参考:根据业务特点参考实施
如果你是业务开发人员,你需要了解 Redis 的运行机制,例如各个命令的执行时间复杂度、数据过期策略、数据淘汰策略等,使用合理的命令,并结合业务场景进行优化。
 如果你是 DBA 运维人员,你需要在资源规划、运维、监控、安全层面做到位,做到未雨绸缪。